


Formulaire - Tests statistiques
Un test statistique permet de décider, au vu d'un échantillon, si une hypothèse sur la population est compatible avec les observations. On procède en cinq étapes :
- On formule l'hypothèse nulle ${H_0}$ (par exemple « ${p=0{,}05}$ ») et l'hypothèse alternative ${H_1}$ (« ${p\neq0{,}05}$ » : test bilatéral ; « ${p>0{,}05}$ » : test unilatéral).
- On choisit le seuil (ou risque) ${\alpha}$, souvent ${5\,\%}$.
- On choisit une statistique de test, dont on connaît la loi lorsque ${H_0}$ est vraie.
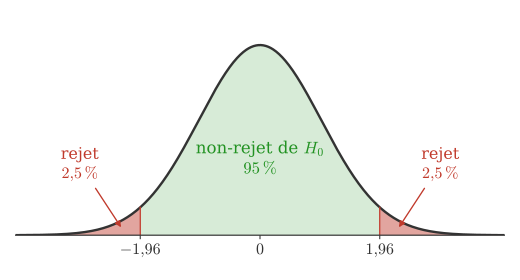
- On en déduit la région de rejet : l'ensemble des valeurs de la statistique qui n'ont qu'une probabilité ${\alpha}$ d'être atteintes si ${H_0}$ est vraie.
- On calcule la statistique sur l'échantillon : si elle tombe dans la région de rejet, on rejette ${H_0}$ au seuil ${\alpha}$ ; sinon, on ne la rejette pas.
Ne pas rejeter ${H_0}$ ne prouve pas qu'elle est vraie : cela signifie seulement que les données ne permettent pas de la contredire.
| ${H_0}$ vraie | ${H_0}$ fausse | |
| on rejette ${H_0}$ | erreur de première espèce (probabilité ${\alpha}$) | bonne décision (probabilité ${1-\beta}$, la puissance) |
| on ne rejette pas ${H_0}$ | bonne décision | erreur de seconde espèce (probabilité ${\beta}$) |
- Diminuer ${\alpha}$ augmente ${\beta}$ : à taille d'échantillon fixée, on ne peut pas rendre les deux risques petits à la fois. Augmenter ${n}$ augmente la puissance.
- La p-valeur est la probabilité, si ${H_0}$ est vraie, d'obtenir une statistique au moins aussi extrême que celle observée. On rejette ${H_0}$ au seuil ${\alpha}$ si et seulement si la p-valeur est inférieure à ${\alpha}$.
La région de rejet est délimitée par une valeur critique, que l'on lit dans la table de la loi de la statistique de test. Prenons une statistique ${Z}$ qui suit la loi normale ${\mathcal N(0,1)}$ lorsque ${H_0}$ est vraie, et un seuil ${\alpha}$. On note ${u_\alpha}$ le réel tel que ${P(|Z|>u_\alpha)=\alpha}$ (par exemple ${u_{0{,}05}=1{,}96}$ et ${u_{0{,}10}=1{,}645}$, voir la fiche estimation).
- Test bilatéral (${H_1}$ : « ${\mu\neq\mu_0}$ ») : on rejette ${H_0}$ si ${|Z|>u_\alpha}$. Le risque ${\alpha}$ est partagé entre les deux queues de la loi, ${\alpha/2}$ de chaque côté : c'est la figure du début de la fiche, avec ${\pm1{,}96}$ pour ${\alpha=5\,\%}$.
- Test unilatéral (${H_1}$ : « ${\mu>\mu_0}$ ») : on rejette ${H_0}$ seulement si ${Z}$ est trop grand, c'est-à-dire si ${Z>c}$ avec ${P(Z>c)=\alpha}$. Tout le risque ${\alpha}$ est cette fois dans une seule queue. Comme la loi est symétrique, ${P(|Z|>c)=2\alpha}$, donc ${c=u_{2\alpha}}$ : on lit la table à ${2\alpha}$. Pour ${\alpha=5\,\%}$, on obtient ${c=u_{0{,}10}=1{,}645}$ au lieu de ${1{,}96}$.
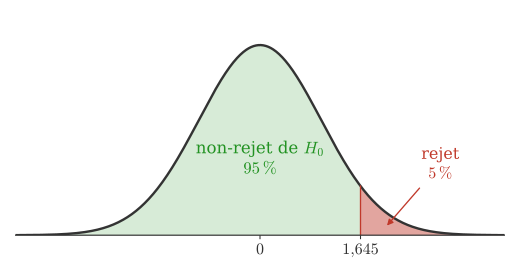
- Avec une statistique ${T}$ de loi de Student, c'est la même chose : la table de Student donne ${t_\alpha}$ tel que ${P(|T|>t_\alpha)=\alpha}$ ; on utilise ${t_\alpha}$ en test bilatéral et ${t_{2\alpha}}$ en test unilatéral.
Si la proportion ${p}$ d'un caractère dans la population est connue (ou supposée), la fréquence ${F}$ observée sur un échantillon de taille ${n}$ appartient, avec une probabilité d'environ ${95\,\%}$, à l'intervalle de fluctuation $$\left[p-1{,}96\sqrt{\frac{p(1-p)}{n}}\ ;\ p+1{,}96\sqrt{\frac{p(1-p)}{n}}\right]$$ (conditions : ${n\geq30}$, ${np\geq5}$, ${n(1-p)\geq5}$). Règle de décision : si la fréquence observée ${f}$ n'appartient pas à cet intervalle, on rejette l'hypothèse « la proportion vaut ${p}$ » au seuil de ${5\,\%}$ ; sinon, on ne la rejette pas. C'est un test bilatéral sur une proportion.
On teste ${H_0}$ : « ${\mu=\mu_0}$ » (ou « ${p=p_0}$ »). On calcule la statistique ci-dessous ; en test bilatéral, on rejette ${H_0}$ si sa valeur absolue dépasse ${u_\alpha}$ (ou ${t_\alpha}$) ; en test unilatéral, on compare avec ${u_{2\alpha}}$ (ou ${t_{2\alpha}}$), du côté indiqué par ${H_1}$.
- Moyenne, ${\sigma}$ connu (loi normale ou ${n\geq30}$) : ${\displaystyle Z=\frac{\bar x-\mu_0}{\sigma/\sqrt n}}$, de loi ${\mathcal N(0,1)}$ sous ${H_0}$.
- Moyenne, ${\sigma}$ inconnu, loi normale : ${\displaystyle T=\frac{\bar x-\mu_0}{s/\sqrt n}}$, de loi de Student à ${n-1}$ degrés de liberté sous ${H_0}$ (pour ${n\geq 30}$, on peut utiliser la loi normale).
- Proportion (${np_0\geq5}$ et ${n(1-p_0)\geq5}$) : ${\displaystyle Z=\frac{f-p_0}{\sqrt{p_0(1-p_0)/n}}}$, de loi approximativement ${\mathcal N(0,1)}$ sous ${H_0}$.
On dispose de deux échantillons indépendants, de tailles ${n_1}$ et ${n_2}$, et on teste l'égalité des moyennes (${\mu_1=\mu_2}$) ou des proportions (${p_1=p_2}$).
- Deux moyennes, grands échantillons (${n_1,n_2\geq30}$) : $$Z=\frac{\bar x_1-\bar x_2}{\sqrt{\dfrac{s_1^2}{n_1}+\dfrac{s_2^2}{n_2}}},\quad\textrm{de loi approximativement }\mathcal N(0,1).$$
- Deux moyennes, petits échantillons (lois normales de même variance) : avec la variance commune estimée $$s^2=\frac{(n_1-1)s_1^2+(n_2-1)s_2^2}{n_1+n_2-2},$$ $$T=\frac{\bar x_1-\bar x_2}{s\sqrt{\dfrac1{n_1}+\dfrac1{n_2}}},$$ de loi de Student à ${n_1+n_2-2}$ degrés de liberté.
- Deux proportions : avec la fréquence globale ${\hat p=\dfrac{n_1f_1+n_2f_2}{n_1+n_2}}$, $$Z=\frac{f_1-f_2}{\sqrt{\hat p(1-\hat p)\left(\dfrac1{n_1}+\dfrac1{n_2}\right)}},\quad\textrm{de loi approximativement }\mathcal N(0,1).$$
- Test d'adéquation : on veut savoir si des observations suivent une loi donnée. On répartit les ${n}$ observations en ${k}$ classes ; ${O_i}$ est l'effectif observé dans la classe ${i}$ et ${E_i=np_i}$ l'effectif attendu sous ${H_0}$. On calcule $$\chi^2=\sum_{i=1}^k\frac{(O_i-E_i)^2}{E_i}.$$ Sous ${H_0}$, cette quantité suit approximativement une loi du ${\chi^2}$ à ${k-1-r}$ degrés de liberté, où ${r}$ est le nombre de paramètres de la loi qu'on a dû estimer à partir des données. On rejette ${H_0}$ si ${\chi^2}$ dépasse la valeur lue dans la table du χ². Condition : tous les ${E_i}$ doivent être au moins égaux à ${5}$ (sinon, on regroupe des classes).
- Test d'indépendance : on observe deux caractères qualitatifs sur ${n}$ individus, et on range les effectifs ${O_{ij}}$ dans un tableau de contingence à ${r}$ lignes et ${c}$ colonnes. Sous l'hypothèse d'indépendance, l'effectif attendu dans la case ${(i,j)}$ est $$E_{ij}=\frac{(\textrm{total de la ligne } i)\times(\textrm{total de la colonne } j)}{n}.$$ La statistique ${\displaystyle\chi^2=\sum_{i,j}\frac{(O_{ij}-E_{ij})^2}{E_{ij}}}$ suit approximativement une loi du ${\chi^2}$ à ${(r-1)(c-1)}$ degrés de liberté.
Pour tester si un échantillon de taille ${n}$ provient d'une loi continue de fonction de répartition ${F}$ donnée, on compare ${F}$ à la fonction de répartition empirique ${F_n}$ (${F_n(x)}$ est la proportion des observations inférieures ou égales à ${x}$) : $$D_n=\sup_{x}|F_n(x)-F(x)|.$$ On rejette ${H_0}$ si ${D_n}$ dépasse la valeur lue dans la table de Kolmogorov-Smirnov. Contrairement au test du ${\chi^2}$, il ne demande pas de regrouper les données en classes.
Proportion : un fabricant annonce ${5\,\%}$ de pièces défectueuses. Sur un échantillon de ${400}$ pièces, on en trouve ${30}$, soit ${f=0{,}075}$. On teste ${H_0}$ : « ${p=0{,}05}$ » contre ${H_1}$ : « ${p>0{,}05}$ » au seuil de ${5\,\%}$. $$Z=\frac{0{,}075-0{,}05}{\sqrt{0{,}05\times0{,}95/400}}\approx2{,}29>1{,}645.$$ On rejette ${H_0}$ : l'annonce du fabricant semble trop optimiste. La p-valeur vaut environ ${0{,}011}$. Avec la méthode du lycée, l'intervalle de fluctuation à ${95\,\%}$ est ${[0{,}029\,;0{,}071]}$, qui ne contient pas ${0{,}075}$ : même conclusion.
Adéquation : on lance ${120}$ fois un dé et on obtient les effectifs suivants.
| face | ${1}$ | ${2}$ | ${3}$ | ${4}$ | ${5}$ | ${6}$ |
| effectif observé | ${15}$ | ${18}$ | ${22}$ | ${25}$ | ${17}$ | ${23}$ |
Si le dé est équilibré, chaque effectif attendu vaut ${E_i=20}$. On calcule $$\chi^2=\frac{25+4+4+25+9+9}{20}=3{,}8.$$ Avec ${6-1=5}$ degrés de liberté, la table donne ${11{,}07}$ au seuil de ${5\,\%}$. Comme ${3{,}8<11{,}07}$, on ne rejette pas l'hypothèse que le dé est équilibré (p-valeur environ ${0{,}58}$).