


Formulaire - Estimation : estimateurs et intervalles de confiance
On étudie un caractère dans une population, dont la loi dépend d'un paramètre inconnu ${\theta}$ : une moyenne ${\mu}$, une proportion ${p}$, un écart-type ${\sigma}$... On dispose d'un échantillon de taille ${n}$, c'est-à-dire de ${n}$ variables aléatoires ${X_1,\dots,X_n}$ indépendantes et de même loi que le caractère étudié, et des valeurs observées ${x_1,\dots,x_n}$. Estimer ${\theta}$, c'est en donner une valeur approchée (estimation ponctuelle) ou un intervalle qui le contient avec une probabilité donnée (intervalle de confiance).
- Un estimateur de ${\theta}$ est une variable aléatoire ${T_n}$ fonction de ${X_1,\dots,X_n}$ ; sa valeur calculée sur les observations est une estimation de ${\theta}$.
- Le biais de ${T_n}$ est ${E(T_n)-\theta}$. L'estimateur est sans biais si ${E(T_n)=\theta}$, asymptotiquement sans biais si ${E(T_n)\to\theta}$.
- L'estimateur est convergent si ${T_n}$ tend vers ${\theta}$ en probabilité. C'est le cas s'il est (asymptotiquement) sans biais et si ${V(T_n)\to 0}$.
- Erreur quadratique moyenne : $$E\big((T_n-\theta)^2\big)=V(T_n)+\big(E(T_n)-\theta\big)^2.$$ Entre deux estimateurs sans biais, on préfère celui de plus petite variance.
Les estimateurs usuels :
| Paramètre | Estimateur | Propriétés |
| moyenne ${\mu}$ | ${\displaystyle\bar X=\frac1n\sum_{k=1}^n X_k}$ | sans biais, ${V(\bar X)=\dfrac{\sigma^2}n}$ |
| proportion ${p}$ | fréquence ${F}$ observée | sans biais, ${V(F)=\dfrac{p(1-p)}n}$ |
| variance ${\sigma^2}$ | ${\displaystyle S^2=\frac{1}{n-1}\sum_{k=1}^n (X_k-\bar X)^2}$ | sans biais |
| variance ${\sigma^2}$ | ${\displaystyle \frac{1}{n}\sum_{k=1}^n (X_k-\bar X)^2}$ | biaisé : espérance ${\dfrac{n-1}n\sigma^2}$ |
C'est pour obtenir un estimateur sans biais de la variance qu'on divise par ${n-1}$ et non par ${n}$ (variance corrigée ${s^2}$ de la fiche de statistique descriptive). En physique, ${s/\sqrt n}$ est l'incertitude-type (de type A) sur la moyenne de ${n}$ mesures.
Si ${f(x;\theta)}$ désigne la densité de ${X}$ (ou ${P(X=x)}$ dans le cas discret), la vraisemblance de l'échantillon observé est $$L(\theta)=\prod_{k=1}^n f(x_k;\theta).$$ L'estimateur du maximum de vraisemblance est la valeur ${\hat\theta}$ qui rend ${L(\theta)}$ maximale. En pratique, on cherche à annuler la dérivée de ${\ln L(\theta)}$. Exemples :
- loi de Bernoulli de paramètre ${p}$ : ${\hat p=\bar x}$ (la fréquence observée) ;
- loi de Poisson de paramètre ${\lambda}$ : ${\hat\lambda=\bar x}$ ;
- loi exponentielle de paramètre ${\lambda}$ : ${\hat\lambda=\dfrac1{\bar x}}$ ;
- loi normale ${\mathcal N(\mu,\sigma^2)}$ : ${\hat\mu=\bar x}$ et ${\hat\sigma^2=\dfrac1n\sum_k(x_k-\bar x)^2}$.
La méthode des moments, plus simple, consiste à égaler les moments théoriques (${E(X)}$, ${E(X^2)}$...) aux moments observés (${\bar x}$, ${\overline{x^2}}$...).
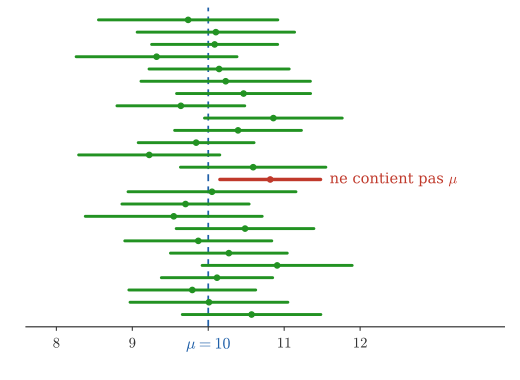
Un intervalle de confiance au niveau ${1-\alpha}$ (par exemple ${95\,\%}$ pour ${\alpha=0{,}05}$) est un intervalle ${[A,B]}$, calculé à partir de l'échantillon, tel que ${P(A\leq\theta\leq B)=1-\alpha}$. Ce sont les bornes qui sont aléatoires, pas ${\theta}$ : si l'on répète l'expérience, environ ${95\,\%}$ des intervalles obtenus contiennent ${\theta}$. Sur la figure, ${25}$ échantillons ont donné ${25}$ intervalles de confiance à ${95\,\%}$ pour une moyenne ${\mu}$ ; un seul ne la contient pas.
On note ${u_\alpha}$ le réel tel que ${P(-u_\alpha\leq Z\leq u_\alpha)=1-\alpha}$ pour ${Z}$ de loi ${\mathcal N(0,1)}$, et ${t_\alpha}$ le réel tel que ${P(|T|>t_\alpha)=\alpha}$ pour ${T}$ de loi de Student à ${n-1}$ degrés de liberté (voir la table de Student).
| niveau de confiance ${1-\alpha}$ | ${90\,\%}$ | ${95\,\%}$ | ${99\,\%}$ |
| ${u_\alpha}$ | ${1{,}645}$ | ${1{,}960}$ | ${2{,}576}$ |
Dans toute la suite, ${\bar x}$ et ${s}$ désignent la moyenne et l'écart-type corrigé de l'échantillon, ${\mu}$ et ${\sigma}$ ceux de la population.
- Moyenne, écart-type ${\sigma}$ connu (loi normale, ou ${n\geq 30}$) : $$\left[\bar x-u_\alpha\frac{\sigma}{\sqrt n}\ ;\ \bar x+u_\alpha\frac{\sigma}{\sqrt n}\right].$$
- Moyenne, écart-type inconnu, loi normale : on remplace ${\sigma}$ par ${s}$, et ${u_\alpha}$ par ${t_\alpha}$ à ${n-1}$ degrés de liberté : $$\left[\bar x-t_\alpha\frac{s}{\sqrt n}\ ;\ \bar x+t_\alpha\frac{s}{\sqrt n}\right].$$ Pour ${n\geq 30}$, on peut garder ${u_\alpha}$, même si la loi n'est pas normale.
- Proportion (${n\geq 30}$, ${nf\geq 5}$ et ${n(1-f)\geq 5}$, où ${f}$ est la fréquence observée) : $$\left[f-u_\alpha\sqrt{\frac{f(1-f)}{n}}\ ;\ f+u_\alpha\sqrt{\frac{f(1-f)}{n}}\right].$$ Au lycée, on utilise souvent, au niveau ${95\,\%}$, l'intervalle plus simple $$\left[f-\frac1{\sqrt n}\ ;\ f+\frac1{\sqrt n}\right],$$ qui le contient toujours.
- Variance, loi normale : pour une loi du ${\chi^2}$ à ${n-1}$ degrés de liberté, on note ${c_1}$ et ${c_2}$ les réels tels que $$P(\chi^2<c_1)=P(\chi^2>c_2)=\frac\alpha2.$$ L'intervalle de confiance est alors $$\left[\frac{(n-1)s^2}{c_2}\ ;\ \frac{(n-1)s^2}{c_1}\right].$$
La demi-longueur de l'intervalle s'appelle la marge d'erreur ${e}$. Elle diminue comme ${1/\sqrt n}$ : pour diviser la marge par ${2}$, il faut multiplier la taille de l'échantillon par ${4}$. Pour obtenir une marge au plus ${e}$ :
- pour une moyenne : ${n\geq\left(\dfrac{u_\alpha\,\sigma}{e}\right)^2}$ ;
- pour une proportion, dans le pire des cas ${p=\frac12}$ : ${n\geq\dfrac{u_\alpha^2}{4e^2}}$, soit environ ${\dfrac1{e^2}}$ au niveau ${95\,\%}$.
Sondage : sur ${n=1000}$ personnes interrogées, ${540}$ sont favorables à un projet, donc ${f=0{,}54}$. On cherche la proportion ${p}$ de personnes favorables dans toute la population : on utilise l'intervalle de confiance d'une proportion, ce qui est légitime car ${n\geq30}$, ${nf=540\geq5}$ et ${n(1-f)=460\geq5}$. Au niveau ${95\,\%}$, ${u_\alpha=1{,}96}$ et la marge d'erreur vaut $$1{,}96\sqrt{\frac{0{,}54\times0{,}46}{1000}}\approx0{,}031,$$ d'où l'intervalle de confiance ${[0{,}509\,;0{,}571]}$ : on peut affirmer, avec une confiance de ${95\,\%}$, que la majorité de la population est favorable. L'intervalle du lycée donne ${[0{,}508\,;0{,}572]}$.
Mesures : on mesure ${10}$ fois la période d'un pendule. On trouve ${\bar x=2{,}012}$ sec et ${s=0{,}015}$ sec. On cherche la période ${\mu}$ du pendule, c'est-à-dire la moyenne de toutes les mesures qu'on pourrait faire. On suppose que les erreurs de mesure suivent une loi normale ; ${\sigma}$ est inconnu et l'échantillon est petit : on utilise donc l'intervalle de confiance d'une moyenne, écart-type inconnu, avec la loi de Student à ${n-1=9}$ degrés de liberté. Avec ${t_{0{,}05}=2{,}262}$, la marge vaut $$2{,}262\times\frac{0{,}015}{\sqrt{10}}\approx0{,}011\textrm{ sec},$$ d'où l'intervalle de confiance à ${95\,\%}$ : ${[2{,}001\,;2{,}023]}$ sec. L'incertitude-type sur la moyenne est ${s/\sqrt{10}\approx0{,}005}$ sec.
Pour décider, au vu d'un échantillon, si une hypothèse sur la population est plausible, voir la fiche tests statistiques.