


Formulaire - Statistique à deux variables et régression linéaire
On observe deux caractères quantitatifs sur $N$ individus : on obtient $N$ couples $(x_1,y_1),\dots,(x_N,y_N)$. Leur représentation dans un repère est le nuage de points. Le point moyen du nuage est $G(\bar x,\bar y)$, où $$\bar x=\frac1N\sum_{k=1}^N x_k\quad\textrm{et}\quad\bar y=\frac1N\sum_{k=1}^N y_k.$$ On note $V_x$, $\sigma_x$ et $V_y$, $\sigma_y$ les variances et écarts-types de chaque série (voir la fiche de statistique à une variable).
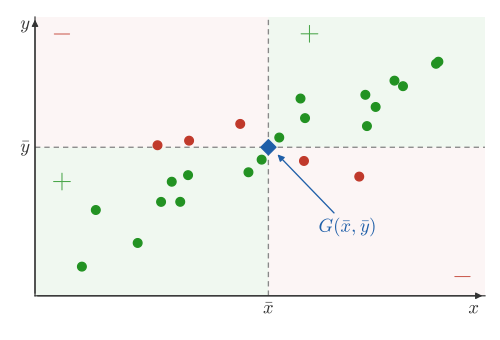
Les droites d'équations $x=\bar x$ et $y=\bar y$ partagent le plan en quatre zones. Pour les points des zones vertes, le produit $(x_k-\bar x)(y_k-\bar y)$ est positif ; pour ceux des zones rouges, il est négatif. Quand la plupart des points sont dans les zones vertes, comme ici, la covariance (ci-dessous) est positive.
- Définition : $$\textrm{cov}(x,y)=\frac1N\sum_{k=1}^N (x_k-\bar x)(y_k-\bar y).$$
- Formule de König-Huygens : $\textrm{cov}(x,y)=\overline{xy}-\bar x\,\bar y$, où $\overline{xy}=\dfrac1N\displaystyle\sum_{k=1}^N x_ky_k$.
- Propriétés : $\textrm{cov}(x,x)=V_x$, $\textrm{cov}(x,y)=\textrm{cov}(y,x)$, et pour des réels $a,b,c,d$, $$\textrm{cov}(ax+b,\,cy+d)=ac\,\textrm{cov}(x,y),\qquad V_{x+y}=V_x+V_y+2\,\textrm{cov}(x,y).$$
- Signe : une covariance positive traduit une tendance des deux caractères à varier dans le même sens, une covariance négative une tendance à varier en sens contraire.
- Définition : $$r=\frac{\textrm{cov}(x,y)}{\sigma_x\sigma_y}.$$
- On a toujours $-1\leq r\leq 1$ (c'est l'inégalité de Cauchy-Schwarz). De plus, $|r|=1$ si et seulement si les points du nuage sont alignés.
- Interprétation : plus $|r|$ est proche de $1$, plus le nuage est proche d'une droite ; le signe de $r$ est celui de la pente. En pratique, on considère souvent qu'un ajustement affine est justifié quand $|r|$ dépasse $0{,}9$ environ, mais ce seuil dépend du domaine.
- Attention :
- $r$ ne mesure que la liaison affine : avec $y_k=x_k^2$ et des $x_k$ répartis symétriquement autour de $0$, on obtient $r=0$ alors que $y$ dépend entièrement de $x$ ;
- une forte corrélation ne prouve pas un lien de cause à effet : les deux caractères peuvent dépendre tous deux d'un troisième ;
- $r$ est très sensible aux valeurs extrêmes : il faut toujours regarder le nuage de points.
Théorème : si $V_x\neq 0$, il existe une unique droite $y=ax+b$ qui rend minimale la somme des carrés des écarts verticaux $$S(a,b)=\sum_{k=1}^N\big(y_k-(ax_k+b)\big)^2.$$ Elle est donnée par $$a=\frac{\textrm{cov}(x,y)}{V_x}=r\,\frac{\sigma_y}{\sigma_x},\qquad b=\bar y-a\bar x.$$ C'est la droite de régression de $y$ en $x$, ou droite des moindres carrés. Elle passe par le point moyen $G$.
- Les résidus sont les écarts $e_k=y_k-(ax_k+b)$. Leur somme est nulle, et leur moyenne des carrés vaut $$\frac1N\sum_{k=1}^N e_k^2=V_y\,(1-r^2).$$
- On utilise la droite pour faire des prévisions : à une valeur $x$, on associe $\hat y=ax+b$. Une prévision faite loin des valeurs observées (extrapolation) est à prendre avec prudence.
- Droite de régression de $x$ en $y$ : en minimisant les écarts horizontaux, on obtient la droite $x=a'y+b'$ avec $a'=\dfrac{\textrm{cov}(x,y)}{V_y}$ et $b'=\bar x-a'\bar y$. Elle passe aussi par $G$, et $aa'=r^2$ : les deux droites sont confondues si et seulement si $|r|=1$.
En notant $\hat y_k=ax_k+b$ les valeurs ajustées, on a la décomposition de la variation totale : $$\underbrace{\sum_{k}(y_k-\bar y)^2}_{\textrm{totale}}=\underbrace{\sum_{k}(\hat y_k-\bar y)^2}_{\textrm{expliquée}}+\underbrace{\sum_{k}(y_k-\hat y_k)^2}_{\textrm{résiduelle}}.$$ Le coefficient de détermination est la part de la variation expliquée par la droite : $$R^2=\frac{\sum_k(\hat y_k-\bar y)^2}{\sum_k(y_k-\bar y)^2}=r^2.$$ Par exemple, $R^2=0{,}95$ signifie que la droite « explique » $95\,\%$ de la variance de $y$.
Quand le nuage n'a pas une forme rectiligne, un changement de variable permet souvent de se ramener à un ajustement affine. On fait la régression de $Y$ en $X$, puis on revient aux variables de départ.
| Modèle | Changement de variable | Droite obtenue |
| exponentiel $y=k\,e^{\alpha x}$ ($k>0$) | $Y=\ln y$ | $Y=\alpha x+\ln k$ |
| puissance $y=k\,x^{\alpha}$ ($k,x>0$) | $X=\ln x$, $Y=\ln y$ | $Y=\alpha X+\ln k$ |
| logarithmique $y=\alpha\ln x+\beta$ | $X=\ln x$ | $y=\alpha X+\beta$ |
| inverse $y=\dfrac{\alpha}{x}+\beta$ | $X=\dfrac1x$ | $y=\alpha X+\beta$ |
| quadratique $y=\alpha x^2+\beta$ | $X=x^2$ | $y=\alpha X+\beta$ |
Attention : la droite obtenue minimise les écarts sur $Y$, pas sur $y$. Ce n'est donc pas exactement l'ajustement des moindres carrés pour le modèle de départ.
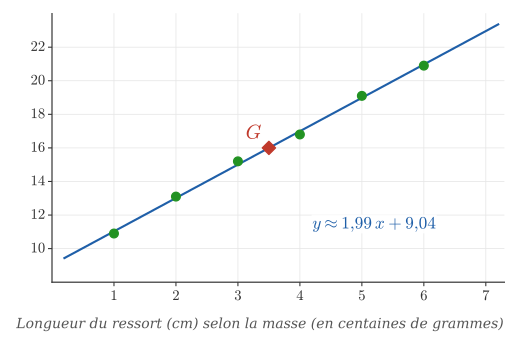
Exemple : on suspend à un ressort une masse de $x$ centaines de grammes et on mesure sa longueur $y$ en cm.
| $x_k$ | $1$ | $2$ | $3$ | $4$ | $5$ | $6$ |
| $y_k$ | $10{,}9$ | $13{,}1$ | $15{,}2$ | $16{,}8$ | $19{,}1$ | $20{,}9$ |
- Point moyen : $\bar x=3{,}5$ et $\bar y=16$, donc $G(3{,}5\,;16)$.
- Covariance : $\overline{xy}=61{,}8$, donc $\textrm{cov}(x,y)=61{,}8-3{,}5\times16=5{,}8$.
- Variances : $V_x=\dfrac{35}{12}\approx2{,}917$ et $V_y\approx 11{,}553$.
- Droite de régression : $$a=\frac{5{,}8}{35/12}\approx1{,}989,\qquad b=16-a\times3{,}5=9{,}04,$$ soit $y\approx1{,}99\,x+9{,}04$.
- Corrélation : $r=\dfrac{5{,}8}{\sqrt{V_xV_y}}\approx0{,}9992$ et $R^2\approx0{,}998$.
- Interprétation : le ressort mesure environ $9{,}0$ cm à vide et s'allonge d'environ $2{,}0$ cm par centaine de grammes. Prévision pour $700$ g : $y\approx 1{,}989\times7+9{,}04\approx 23{,}0$ cm.
Pour les variables aléatoires, voir la fiche espérance, variance, covariance.